rdanis@ethz.ch
Jede Woche ein Moodle Quiz für 0.25 Binus, bei ≥
Quiz Freitagmorgen freigeschaltet, bis nächsten Donnerstagabend lösen
LGS
Rang und Loesungsdiskussion
Rang = →
n R = ^ n v = ^
n R = n V
Verträglichkeit (KB) erfüllt -> genau eine Lösung
nicht erfüllt -> keine Lösungn R < n V
Verträglichkeit (KB) erfüllt -> unendlich viele Lösungen
nicht erfüllt -> keine Lösung
Tricks beim Eliminationsverfahren
Zeilen vertauschen
Spalten vertauschen (aufpassen! -> Reihenfolge der Variablen wird vertauscht; ist aber nützlich zur Rangbestimmung)
Matrizen
Matrizen haben 2 Dimensionen
m = ^ n = ^
Notation: A ∈ R m x n
Bei Vektoren lässt man die zweite Dimension weg
Matrizen addieren :
geht nur wenn Matrizen gleiche Dimension haben
Einträge individuell miteinander addieren
Matrixmultiplikation :
Form: Zeilen mal Spalten
Wir können 2 Matrizen A ∈ R m 1 x n 1 B ∈ R m 2 x n 2 A B n 1 = ! m 2
A B ∈ R m 1 ∗ n 2 nur, wenn anzahl variablen A B
nicht kommutativ
Matrix-Vektor-Multiplikation :
Matrix in Spalten "aufspalten", jede Spalte mit einem Vektoreintrag multiplizieren, dann Zeilen der Matrixspalten (lineare Kombination) addieren -> Vektor
[ 1 4 7 2 5 8 3 6 9 ] ∗ [ 1 2 3 ] = [ 1 2 3 ] ∗ 1 + [ 4 5 6 ] ∗ 2 + [ 7 8 9 ] ∗ 3 = ⋯ = [ 30 36 42 ] LGS als Matrixmultiplikation
allgemein in der form A x = B x b
[ 1 3 4 2 ] ∗ [ x 1 x ∗ 2 ] = [ 4 5 ]
LGS A x = b A
[ 1 0 0 0 ] → x 1 ∗ [ 1 0 ] + x 2 ∗ [ 0 0 ] = [ x 1 0 ]
Tipp: Überprüfen, ob Ergebnis Vielfaches von einer Spalte ist
Generell lässt sich ein LGS für jede rechte Seite b r = n = m
Transponierte
Die Transponierte A ⊤ A an der Hauptdiagonalen
A = [ 1 2 3 4 5 6 ] , A ⊤ = [ 1 4 2 5 3 6 ] A = [ 1 3 3 ] , A ⊤ = [ 1 2 3 ] Wenn gilt A ⊤ = A A n = m
a ∈ R m × n ⟹ A ⊤ ∈ R n × m -> Dimensionen werden vertauscht( A ⊤ ) ⊤ = A
Inverse
Eine Matrix A ∈ R n × n A − 1 ∈ R n × n
A A − 1 = A − 1 A = I ⏟ Einheitsmatrix
Einheitsmatrix I = ^ 1 0
A 2 × 2 = [ 1 0 0 1 ] A − 1 = 1 a d − b c [ d − b − c a ] -> existiert nur wenn Nenner a d − b c ≠ 0 A A ⊤ = I
I 3 × 3 = [ 1 0 0 0 1 0 0 0 1 ] I 3 × 3 − 1 = I 3 × 3
für Permutationsmatrizen gilt auch A − 1 = A
Rechenregeln
ü i) ( A B ) ⊤ = B ⊤ A ⊤ ( A B C ) ⊤ = C ⊤ ( A B ) ⊤ ⏟ wegen i) = C ⊤ B ⊤ A ⊤ ⏟ nochmals i) ii) ( A B ) − 1 = B − 1 A − 1 falls A − 1 , B − 1 existieren A,B müssen quadratisch sein iii) ( A − 1 ) ⊤ = ( A ⊤ ) − 1 A ⊤ ( A − 1 ) ⊤ = ( A − 1 A ) ⊤ Rechenregel i) = ( I ⊤ ) ⊤ I − 1 = I , I ⊤ = I = I ◻ LU-Zerlegung
Zerlegen matrix in Produkt aus unterer und oberer Dreiecksmatrix
ü P A = L U P : Permutationsmatrixx für vertauschen von Zeilen L : Protokollmatrix, untere Dreiecksmatrix U : Dreiecksmatrix, Resultat aus Gaussverfahren
L protokolliert Gauss-Schritte mit negativen Vorzeichen
Zeilenvertauschung in Permutationsmatrix (dort auch entsprechende Zeilen vertauschen)
Zeilenvertauschung darf nur am Anfang stattfinden
am Ende L U A
P A = L U A ∈ R m × n L ∈ R m × m U ∈ R m × n P ∈ R m × m Achtung!
LU-Zerlegung von
[ 2 3 3 4 ] 2 I I − 3 I I I − 3 2 I immer normalisieren!
L = [ 1 0 3 2 1 ] , U = [ 2 3 0 − 1 2 ] Euklidische Norm
| | x | | = x 1 2 + x 2 2 + ⋯ + x n 2
Wichtig für Normalisierung auf Länge 1:
x ^ = x | | x | |
ü | | a x → | | = | a | | | x → | | F ü r a ∈ R , x → ∈ R n
Nützliche Interpretation
| | x | | = x 1 2 + ⋯ + x n 2 ⏟ x ⊤ x Skalarprodukt
Multiplikation zweier Vektoren:
< x , y ≥ x ⊤ y = x 1 ∗ y 1 + x 2 ∗ y 2 + ⋯ + x n ∗ y n < x . y >= | | x | | ∗ | | y | | ∗ cos ( α ) α = ^ Winkel zwischen x und y cos ( α ) = x ⊤ y | | x | | ∗ | | y | |
Winkel in π = π w i n k e l π 0.64 ≈ π 5
α cos α sin α
0°
0
1
0
30°
π 6 3 2 1 2
45°
π 4 2 2 2 2
60°
π 3 1 2 3 2
90°
π 2 0
1
Orthogonalität
Zwei Vektoren x , y
x ⊤ y = 0 orthogonale Vektoren finden
Finde y → ≠ 0 → x → ⊤ y → = 0 ∞
Kreuzprodukt (in 3D)
[ 1 2 1 ] × [ 1 0 − 1 ] = [ x 2 y 3 − x 3 y 2 x 3 y 1 − x 1 y 3 x 1 y 2 − x 2 y 1 ] Orthogonale Matrizen
A ∈ R n × n
A ⊤ A = I
alle Spalten von A und haben Länge/Norm 1.
A − 1 = A ⊤ orthogonale Matrizen haben immer vollen Rang
orthogonale Matrizen verändern den Betrag von Vektoren nicht
| | Q x | | = ( Q x ) ⊤ Q x = x ⊤ Q ⊤ Q ⏟ I x = x ⊤ x = | | x | | ◻ Rotationsmatrizen
Sepzielle orthogonale Matrizen die Vektoren rotieren
in 2D:
R ( α ) = [ cos α − sin α sin α cos α ]
Immer, Drehung gegen Uhrzeigersinn
Die Drehungsmatrix ist die Identitätsmatrix, mit der 2D-matrix in der zu drehenden Reihe
In 3D können wir in der x-y, x-z und y-z Ebene drehen, z.B.
R x − y ( α ) = [ cos α − sin α 0 sin α cos α 0 0 0 1 ]
R Wenn wir mehrere Rotationen in derselben Ebene hintereinander ausführen, dann können wir die Winkel addieren:
R x − y ( α ) ∗ R x − y ( β ) = R x , y ( α + β )
Householder-Matrozen
Spiegelung von Vektoren an einer Hyperebene
Brauchen den Normalvektor n →
H = I − 2 n → n → ⊤ QR-Zerlegung
A wird in eine Multiplikation aus orthogonale Matrix B
#todo fertigschreiben
QR-Zerlegung mit householder Matrizen
A = [ 2 ∗ ∗ 2 ∗ ∗ 1 ∗ ∗ ] -> wollen durch Spiegelung zwei Nullen in der ersten Spalte erzeugen
[ 2 2 1 ] z u [ a 0 0 ] transformieren -> beide Vektoren haben gleiche Länge, 3 (ausrechnen!)a = 3 [ 3 0 0 ] [ − 3 0 0 ]
Vektor zwischen x und gespiegelter Vektor:
x − [ 3 0 0 ] = [ 2 2 1 ] − [ 3 0 0 ] = [ − 1 2 1 ] n → = [ − 1 2 1 ] | | [ − 1 2 1 ] | | = 1 6 [ − 1 2 1 ] H 1 = I − 2 n → n → ⊤ = [ 1 0 0 0 1 0 0 0 1 ] − 1 3 [ 1 − 2 − 1 − 2 4 2 − 1 2 1 ] = [ 2 3 2 3 1 3 − 2 3 − 1 3 − 2 3 1 3 − 2 3 2 3 ] = 1 3 [ 2 2 1 2 − 1 − 2 1 − 2 2 ] -> am Schluss überprüfen, ob Matrix stimmen kann
H 1 A = [ 3 ∗ ∗ 0 ∗ ∗ 0 ∗ ⏟ 2. Schritt: hier 0 erzeugen ∗ ] -> noch H 2
hier können wir die erste Spalte und Zeile unberührt lassen
H 2 = [ 1 0 0 0 ∗ ∗ 0 ∗ ∗ ] AM Ende:
A = Q R R = H 2 H 1 A Q = H 1 ⊤ H 2 ⊤ Q R = H 1 ⊤ H 2 ⊤ H 2 H 1 A = A
Für Q muss man transponieren
Prüfungsaufgabe:
A = [ 1 1 1 − 1 1 1 0 02 1 ] A = Q R | | a 1 | | = 3 | | a 2 | | = 6 | | a 3 | | = 3 ->
→ Q = [ 1 2 1 6 1 3 − 1 2 1 6 1 3 0 − 2 6 1 3 ] R = [ 2 0 0 0 6 0 0 0 3 ] Vektorräume
Menge V
a , b ∈ V ⟹ a + b ∈ V α ∈ R , a ∈ V ⟹ α a ∈ V
Entweder beweisen, oder Gegenbeispiel finden (einfacher)
z.B. Ist V = [ − 1 , 2 ] x = 1 ∈ V , y = 2 ∈ V , x + y = 3 ∉ V
Vektorräme erfüllen 7 zusätzliche Eigenschaften
ü ü ä ä i ) a + b = b + a a , b ∈ V kommutativ i i ) ( a + b ) + c = a + ( b + c ) a , b , c ∈ V assoziativ → einfach zu überprüfen i i i ) a + 0 = a 0 , a ∈ V Vektorraum enthält Nullelement i v ) ∀ a ∈ V ∃ − a : a + ( − a ) = 0 enthält negatives Element v ) α ( β x → ) = ( α β ) x → v i ) ( α + β ) x → = α x → + β x → v i i ) 1 ∗ x → = x →
Geraden, Ebenen sind Vektorräume wenn sie den Ursprung enthalten
Bsp :
V = { [ 1 2 3 ] + x [ 7 2 1 ] | x ∈ R } -> Enthält kein Nullvektor, V ist kein Vektorraum
Bsp: Menge aller symmetrischen 2 × 2 A ⊤ = A
V = { [ a b b c ] | a , b , c ∈ R } Ist V
Addition angeschlossen? [ ∗ b 1 + b 2 b 1 + b 2 ∗ ]
Multiplikation abgeschlossen? ✔
Nullelement? Nullmatrix ist symmetrisch ✔
Negatives Element? ✔
-> V
5,6,7 müssen normalerweise nicht gezeigt werden, falls
Bem: Wenn A B B ⊆ A B A
V = { t ∗ [ 1 2 3 ] | t ∈ R } ist ein Unterraum von R 3
Bsp: Vektorraume mit Funktionen als "Vektoren":
P 2 = { a x 2 + b x + c | a , b , c ∈ R 2 } (alle Polynome mit Grad 2 oder kleiner)…
Lineare Kombination
Summe von mit Skalaren multiplizierten Vektoren:
∑ i = 1 k a i x i a i ∈ R , x i ∈ R n
z.b. Matrix-Vektor-Multiplikation
Dimension Vektorraum
Minimale Anzahl Vektoren mittels der sich der gesamte Vektorraum via Linearkombinationen abbilden lässt
Bsp R 3
v 1 = e → 1 , v 2 = e → 2 , v 3 = e → 3 Bsp v 1 , v 2 , v 3
v 1 = [ 1 1 1 ] , v 2 = [ 1 1 0 ] , v 3 = [ 1 0 0 ] -> eine solche Ansammlung an Vektoren wird auch Erzeugendensystem genannt
Bild einer Matrix
Raum, der durch die Spalten aufgespannt wird
A = [ a 1 a 2 … a n ] ∈ R m × n Im ( A ) = s p a n ( a 1 , … , a n )
= { ∑ i = 1 n α i a i | α i ∈ R , a i ∈ R m } Kern einer Matrix
Der Kern einer Matrix A ∈ R m × n A x = 0
ker ( A ) = { x ∈ R n | A x = 0 }
Immer mindestens eine Lösung, den Nullvektor
die Elemente des Kerns sind orhogonal zu den Zeilen von A
Bsp :
[ 1 0 0 2 ] -> da Rang Matrix = 2 A A x = b ker ( A ) = { 0 }
Bsp
A = [ 1 0 2 0 0 0 1 0 0 ] -> Rang 2, ker ( A ) = { a ∗ [ 0 1 0 ] | a ∈ R }
Wenn A ∈ R m × n R m R n
#timestamp 2024-10-24
eure Lösung im Moodle hochladen
mathematisch korrekt und ordentlich arbeiten
Problemstellung
Was muss gezeigt werden
Schritt für schritt logisch argumentieren
Serie 4, Aufgabe 11
Fixiere z ∉ ker ( M ) x v ∈ ker ( M ) x = v + c z v
Trick: nutzen, dass Vektor( M ) ( M v = 0 → ) x M
M x = M ( v + c z ) = M v ⏟ 0 → + M c z ( wobei c ist Skalar ) = c M z c = M x M z M ∈ R 1 × m , z ∈ R M × 1 M z M x
-> setzen
x = v + M x M z z M = [ … ⏟ m ] M x = 0 dim ( ker ( M ) ) ≥ m − 1 M = [ 0 0 … 0 ] → ker ( M ) = R m x = v + M x M z c ⏟ z
Lineare Unabhängigkeit
v 1 , v 2 , … , v n ∈ V
a 1 v 1 + a 2 v 2 + ⋯ + a n v n = 0 → ⟹ a 1 = a 2 = ⋯ = a n = 0 Lineare unabhängigkeit lässt isch durch das Lösen eines homogenen LGS überprüfen:
[ v 1 v 2 … v n ] [ a 1 a 2 … a n ] = [ 0 0 … 0 ] nur wenn a → = [ 0 0 … 0 ] v 1 , … , v n
Es kann nicht mehr linear unabhängige Vektoren als die Dimension des Raumes geben
Wann sind 2 Vektoren linear abhängig?
-> wenn sie dieselbe "Richtung haben"
Bsp: x = [ 1 2 3 ] , y = [ − 10 − 20 − 30 ] x + y = [ 0 0 0 ]
A ∈ R m × n
Anzahl linear unabhägiger Spalten A
= R a n g A = r
= Anzahl linear unabhängiger Zeilen A
Bsp
[ 1 2 3 4 4 4 ] -> Rang =2, da 2 Zeilen unabhängig
Basis
Erzeugendensystem aus linear unabhängigen Elementen v ∈ V
Dimension von V = ^
Bsp
x = [ 1 0 1 ] , y = [ 1 0 0 ] -> z muss in zweiten Eintrag 1 enthalten, um linear unabhängig zu sein und Basis mit x , y z = [ 1 1 1 ]
Fundamentalsatz der linearen Algebra
Recap (A ∈ R m × n
B i l d A = s p a n ( a 1 , … , a n ) = { ∑ i = 1 n x i a i | x i ∈ R , a i ∈ R m } K e r n A = { x ∈ R n | A x = 0 → } daher:
d i m ( B i l d A ) ≤ m d i m ( K e r n A ) ≤ n
d i m ( B i l d A ) = r d i m ( K e r n A ) = k − r
k − r r a n g r d i m ( B i l d A ⊤ ) = r d i m ( K e r n A ⊤ ) = n − r
d i m ( K e r n A ) + d i m ( B i l d A ⊤ ) = k
d i m ( K e r n A ⊤ ) + d i m ( B i l d A ) = n
K e r n A ⊥ B i l d A ⊤
-> Orthogonalität impliziert lineare Unabhängigkeit
K e r n A ∪ B i l d A ⊤ = R k K e r n ( A ⊤ ) ∪ B i l d ( A ) = R n
-> K e r n ( A ) ⏟ d i m k − r ∪ B i l d ( A ) ⏟ d i m r ≠ R k
Bsp :
[ 1 1 0 0 1 1 1 1 0 0 0 0 ] rang=2d i m ( B i l d A ) = 2 d i m ( K e r n A ) = k − r = 3 − 2 = 1
Welche Dimensionan haben die Elemente von B i l d ( A ) R 4
Welche Dimensionen haben die Elemente von K e r n ( A ) A x = 0 λ ∈ R 3
#timestamp 2024-10-31
Koordinaten
Elemente von Vetorräumen können mit unterschiedlichen Basen dargestellt werden
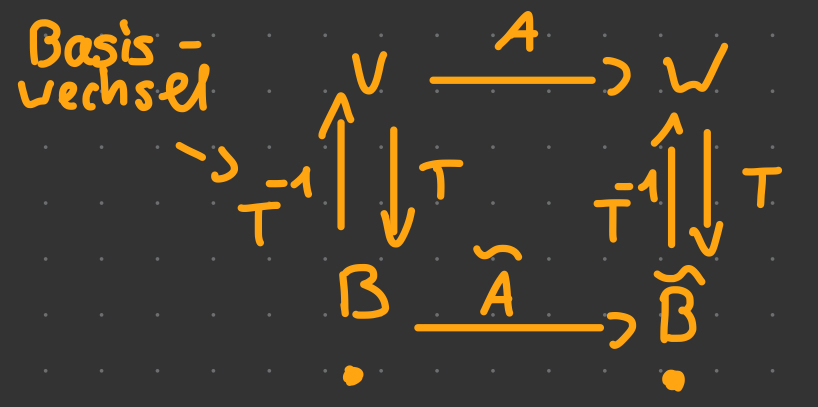
Basiswechsel
Übergang von Koordinaten in Basis B B ~ T
k B ~ ( v ) = T k B ( v )
Matrix T ist gegeben durch:
T = [ k B ~ ( b 1 ) … k B ~ ( b n ) ] -> wir repräsentieren die Basisvektoren von B B ~
Bsp :
B = { [ 1 1 ] , [ 1 0 ] } B ~ = { [ 1 2 ] , [ 2 1 ] } Wir wandeln wie Koordinaten von B nach B ~
b 1 = a [ 1 2 ] + b [ 2 1 ] -> a = 1 3 , b = 1 3
k B ~ ( b 1 ) = [ 1 3 1 3 ] genau gleich:a = − 1 3 , b = 2 3
k B ~ ( b 2 ) = [ − 1 3 2 3 ] die Übergangsmatrix:
T = 1 3 [ 1 − 1 1 2 ] -> am Ende: Sanity check
Basiswechsel einer Matrix
Gegeben Matrix A B B ~
(Annahme, V , W
-> Pfad enthält 3 Matrixen, die miteinander multiplizieren
A ~ = ⊤ A ⊤ − 1 Die Matrix, die zuerst angewendet wird, ist ganz rechts!
Lineare Abbildungen
Abbildung zwischen zwei Vektorrämen v , w
F : V ↦ W , x → F ( x )
erfüllen:
∀ x , y ∈ R F ( x + y ) = F ( x ) + F ( y ) ∀ x ∈ R , a ∈ R F ( a x ) = a F ( x )
Bsp:
v = P 2 = { a x 2 + b x + c | a , b , c ∈ R }
p ∈ V : F ( p ( x ) ) = δ δ x p ( x )
-> überprüfen, ob addition, multiplikation von skalar stimmt
jede lineare Abbildung lässt sich durch eine matrix A
F : V ↦ W d i m ( V ) = n dim ( W ) = m A ∈ R m × n
v = P 2 F ( p ( x ) ) = δ δ x p ( x )
FInde Matrix, die F
B V = { 1 , x , x 2 }
Wie wirkt F
1 ⟺ [ 1 0 0 ] x ⟺ [ 0 1 0 ] x 2 = [ 0 0 1 ] -> F(1) = δ δ x 1 = 0 F ( x 2 ) = δ δ x x 2 = 2 X
A ∈ R m × n
dim ( V ) = n = 3 dim ( W ) = m = 2
A [ 1 0 0 ] = [ 0 0 ] A [ 0 1 0 ] = [ 1 0 ] A [ 0 0 1 ] = [ 0 2 ] → A = [ 0 1 0 0 0 2 ] Vorgehen:
Wie wirkt F
Spaltenweise A
da wir F
p ( x ) ∈ P 2 : F ( p ( x ) ) = δ δ x p ( x )
ker ( F ) = { a | a ∈ R }
-> Ableitung von Konstanten ist 0
dim ( ker ( F ) ) = 1
A = [ 0 1 0 0 0 2 ] ∈ R 2 × 3 3 = d i m ( ker ( F ) ) + dim ( i m ( F ) )
-> d i m ( i m ( F ) ) = 2
Prüfung HS 2024 Aufgabe
a)...1 − x , 2 x , 4 x 2 2 , x 4 , x 2 3 B F
Aus b):
A = [ 1 0 0 0 3 2 0 0 0 7 3 ] A ~ = K A T − 1 Einheitsbasis:
B = { [ 1 − 1 0 ] , [ 0 2 0 ] , [ 0 0 4 ] } Wie stellen wir die Basisvektoren von B
T − 1 = [ 1 0 0 − 1 2 0 0 0 4 ] k B ~
B ~ = { [ 2 0 0 ] , [ 0 1 4 0 ] , [ 0 0 1 3 ] } -> Vektoren der Einheitsbasis in B ~
[ 1 0 0 ] = 1 2 [ 2 0 0 ] + 0 [ 0 1 4 0 ] + 0 [ 0 0 1 3 ] [ 0 1 0 ] = … [ 0 0 1 ] = … K = [ 1 2 0 0 0 4 0 0 0 3 ] aus skalaren der lin. Komb. A ~ = K A T − 1 = ⋯ = [ 1 2 0 0 − 6 12 0 0 0 28 ]
#timestamp 2024-11-07
Norm und Skalarprodukt in linearen Räumen
Norm
Funktionen | | ⋅ | | : v → [ 0 , ∞ [
| | v | | = 0 ⟹ v = 0 → ∀ a ∈ R , ∀ v i n V : | | a v | | = | a | | | v | | | | v + w | | ≤ | | v | | + | | w | | (| | v | | ≥ 0
Bsp: p-Normen
| | x | | p = ( | x 1 p + ⋯ + | x n | p ) 1 / p
p = 2 p = ∞
| | x | | ∞ = lim p → ∞ ( | x 1 p + ⋯ + | x n | p ) ⏟ ≈ max i ∈ { 1 , … , n } | x n | p 1 / p = max i ∈ { 1 , … , n } | x i | | | x | | 1 = | x 1 | + ⋯ + | x n | Äquivalenz der Normen
Wenn | | ⋅ | | | | ⋅ | | ′ x ∈ R n
1 C | | x | | ≤ | | x | | ′ ≤ C | | x | | -> C
Bsp: C | | x | | 2 | | x | | ∞
1 C | | x | | 2 ≤ | | x | | ∞ ≤ C | | x | | 2 | | x | | 2 = x 1 2 + ⋯ + x n 2 Summe unter Wurzel ≥ | | x | | ∞ 2 | | x | | ∞ = max i ∈ { 1 , … , n } | x i | → | | x | | ∞ ≤ | | x | | 2 -> aber C = 1 | | x | | 2 > | | x | | ∞ | | x | | 2 | | x | | ∞
tritt ein wenn alle Einträge von x
x = [ x 1 ⋮ x 1 ] → | | x | | 2 = x 1 2 + ⋯ + x 1 2 ⏟ n = n x 1 2 = n | x 1 | | | x | | ∞ = | x 1 | n c | x 1 | ≤ | x 1 | ⟹ c = n ≥ 1
1 n | | x | | 2 ≤ | | x | | ∞ ≤ n | | x | | 2 Bsp Ist | | x | | = | ∑ x i | 0 | | [ − n n ] | | ∀ n ∈ N = 0
Bsp | | x | | = ∑ | x i | | | x | | = 0 ⟹ x = 0 → | | a x | | = ∑ i | a x i = | a | | | x | | | | x + y | | = ∑ i | x i + y i | ≤ ∑ i | x i | + | y i | = | | x | | + | | y | |
Skalarprodukt
Funktion < . , . >: V × V → R
< x , a y + b z >= a < x , y > + b < x , z > < x , y >=< y , x > < x . x >≥ 0
Norm kann aus Skalarprodukt induziert werden:
| | x | | = < x , x > Bsp euklidische Norm
| | x → | | 2 = x 1 2 + ⋯ + x n 2 = x → ⊤ x = < x → , x → > Bsp Skalarprodukt über Matrix A → x ⊤ A x ≥ 0
< x , y > A = x ⊤ A y Bsp zu Skalarprodukten (x ∈ R 3 < x , y ≥ x 1 y 1 + 2 x 2 y 2 − 3 x 3 y 3
< x , y >=< y , x > ✓ < x , a y + b z >= x 1 < a y 1 + b z 1 >= ⋯ = a < x , y > + b < x , z > ✓ Positiv definit?
< x , x >≥ 0
< [ 0 0 1 ] , [ 0 0 1 ] >= 0 ∗ 0 + 2 ∗ 0 ∗ 0 − 3 ∗ 1 ∗ 1 = − 3 < 2 -> kein Skalarprodukt
zuerst überlegen, ob es ein gegenbeispiel gibt
mit kompliziertester eigenschaft anfangen, um Zeit zu sparen
Summen von Skalarprodukten mit Koeffizienten
≥ 0 sind Skalarprodukte
Orthogonale Projektionen
orthogonale Projektion von x y
P x x = < y , x > < x , x > y -> "Punkt auf y am nächsten zu x" -> Projektion auf y zum Punkt
Bsp abstand von funktionen
F , g ∈ { a x 2 + b x + c | a , b , c ∈ R } < F , g >= ∫ 0 1 F ( x ) g ( x ) d x let
P g F = < F , g > < g , g > g = ∫ 0 1 F ( x ) g ( x ) d x ∫ 0 1 g ( x ) g ( x ) d x g ( x ) = ⋯ = 49 16 ( − x 2 + 2 x )
Winkelberechnung über allgemeines Skalarprodukt:
You can't use 'macro parameter character #' in math mode \alpha=\arccos \frac{|<x,y>|}{||x||||y||} $$- Orthogonal wenn $<x,y>=0$ Wenn 2 Vektoren orthogonal sind, dann ergibt $P_{y}x=P_{x}y=\vec{0}$ > #timestamp 2024-11-14 ### Gram-Schmidt Orthogonalisierungsverfahren - Methode zur Erzeugung einer orthonormalen Basis aus einer gewöhnlichen Basis \alpha=\arccos \frac{|<x,y>|}{||x||||y||} $$- Orthogonal wenn $<x,y>=0$ Wenn 2 Vektoren orthogonal sind, dann ergibt $P_{y}x=P_{x}y=\vec{0}$ > #timestamp 2024-11-14 ### Gram-Schmidt Orthogonalisierungsverfahren - Methode zur Erzeugung einer orthonormalen Basis aus einer gewöhnlichen Basis \begin{align}
∗ ∗ B s p : Q R − Z e r l e g u n g m i t G r a m − S c h m i d t ∗ ∗ \begin{align}
1. G r a m − S c h m i d t a u f S p a l t e n v e k t o r e n \begin{align}
Ü ü 2. B e r e c h n u n g $ R $ ( $ A = Q R $ ) $ R = [ q 1 ⊤ a 1 q 1 ⊤ a 2 0 q 2 ⊤ a 2 ] $ $ = [ 5 1 5 0 12 30 ] $ 3. Ü b e r p r ü f e n \begin{bmatrix}
You can't use 'macro parameter character #' in math mode -> hier ist $Q$ streng genommen keine orthogonale Matrix ### Projektoren - lineare Abbildung $P:V\to V$, für die gilt: -> hier ist $Q$ streng genommen keine orthogonale Matrix ### Projektoren - lineare Abbildung $P:V\to V$, für die gilt: P^2=P
[ b i l d ] − o r t h o g o n a l e r P r o j e k t o r P=P^\top\quad (\text{Matrix muss symmetrisch sein})
( d a n n g i l t $ x − P x ⊥ Bild P $ ) ∗ ∗ B s p ∗ ∗ $ [ 1 0 0 0 1 0 ] $ − > $ P 2 = P $ P r o j e k t i o n ? − > $ P 2 $ e x i s t i e r t n u r w e n n $ P $ q u a d r a t i s c h − > n i c h t P r o j e k t o r ∗ ∗ B s p ∗ ∗ \begin{bmatrix}
P^2 = \begin{bmatrix}
You can't use 'macro parameter character #' in math mode P Projektion orthogonal? $P=P^\top$ -> stimmt nicht ($1$ oben rechts verschiebt sich) -> nicht orthogonal #### Berechnung orthogonaler Projektoren #todo --- - Wenn $U.V$ zwei Matrizen mit $\underbrace{ V^\top U = I }_{ \text{spalten U orthonormal} }$, dann: P Projektion orthogonal? $P=P^\top$ -> stimmt nicht ($1$ oben rechts verschiebt sich) -> nicht orthogonal #### Berechnung orthogonaler Projektoren #todo --- - Wenn $U.V$ zwei Matrizen mit $\underbrace{ V^\top U = I }_{ \text{spalten U orthonormal} }$, dann: P=UV^\top\quad (\text{ist schiefe Projektion auf Spaltenraum von U})
∗ ∗ B s p ∗ ∗ ( v o r h e r i g e s B e i s p i e l ) U=\begin{bmatrix}
ö S u c h e n $ V $ m i t $ V ⊤ U = I $ − m e h r e r e M ö g l i c h k e i t e n V=\begin{bmatrix}
V^\top U = \begin{bmatrix}
P=UV^\top = \dots=\begin{bmatrix}
You can't use 'macro parameter character #' in math mode $P^2=P~\checkmark$ $P^\top=P~\times$ -> schiefe Projektion --- #todo ### Riesz Theorem Sei $F:V\to \mathbb{R}$ ein lineares FUnktional und $V$ Vektorraum - Funktional $\hat{=}$ von Vektorraum auf $\mathbb{R}$ 1. $\exists$ eindeutiges $w \in V$: $F(v)=\left< w,v \right>~~~\forall v \in V$ 2. Sei $b_{1}, b_{2},\dots,b_{n}$ ONB in $V$, dann $w=\overline{F(b_{1})}b_{1}+\dots$ **Bsp** $L(x.y)=2x+3y$ $L(x,y)=\left< \begin{bmatrix}x\\y\end{bmatrix},\begin{bmatrix}2\\3\end{bmatrix} \right>$ -> $w=\begin{bmatrix} 2 \\ 3\end{bmatrix}$ beschreibt $L$ eindeutig > #timestamp 2024-11-21 ## Ausgleichsrechung (Linear Regression) - Finde Funktion die Fehlersumme minimiert $P^2=P~\checkmark$ $P^\top=P~\times$ -> schiefe Projektion --- #todo ### Riesz Theorem Sei $F:V\to \mathbb{R}$ ein lineares FUnktional und $V$ Vektorraum - Funktional $\hat{=}$ von Vektorraum auf $\mathbb{R}$ 1. $\exists$ eindeutiges $w \in V$: $F(v)=\left< w,v \right>~~~\forall v \in V$ 2. Sei $b_{1}, b_{2},\dots,b_{n}$ ONB in $V$, dann $w=\overline{F(b_{1})}b_{1}+\dots$ **Bsp** $L(x.y)=2x+3y$ $L(x,y)=\left< \begin{bmatrix}x\\y\end{bmatrix},\begin{bmatrix}2\\3\end{bmatrix} \right>$ -> $w=\begin{bmatrix} 2 \\ 3\end{bmatrix}$ beschreibt $L$ eindeutig > #timestamp 2024-11-21 ## Ausgleichsrechung (Linear Regression) - Finde Funktion die Fehlersumme minimiert F^*(t)=\arg\min_{F} \sum_{i=1}^n (F(t_{i})-y_{i})^2
ü − F ü r u n s e r e Z w e c k e i s t $ F ( t ) $ m e i s t l i n e a r i n $ t $ F(t)=x_{0}+x_{1}t~(+x_{2}t^2+x_{3}t^3+\dots)
− > $ x 0 , x 1 $ s i n d g e s u c h t e P a r a m e t e r − P r o b l e m e i n M a t r i x − V e k t o r f o r m b r i n g e n : \vec{x}=\begin{bmatrix}
A\vec{x}=\begin{bmatrix}
ö − N u n k ö n n e n w i r d i e F e h l e r s u m m e u m s c h r e i b e n : \sum_{i=1}^n (F(t_{i})-y_{i})^2 = ||Ax-b||^2
− Z i e l f i n d e o p r i m a l e s $ x ^ $ \hat{x} = \arg\min_{x \in \mathbb{R}^n} ||Ax-b||^2
ü − o p t i m a l e $ x ^ $ e r f ü l l e n N o r m a l e n g l e i c h u n g ( H e r l e i t u n g i m S k r i p t ) A^\top A \hat{x} = A^\top b
ö − e i n d e u t i g e L ö s u n g w e n n $ A $ v o l l e n S p a l t e n r a n g h a t => $ A ⊤ A $ i n v e r t i e r b a r : \hat{x} = (A^\top A)^{-1} A^\top b
You can't use 'macro parameter character #' in math mode > [!warning] Ansonsten gibt es $\infty$ Lösungen > Normalengleichung hat niemals keine Lösung # Determinanten - Zahl, welche die Invertierbarkeit von quadratischen Matrizen charakterisiert: - $A \in ^{n\times n}$, $A^{-1}$ existiert genau dann wenn $\det(A)\neq0$ - Konsequenz: Für alle quadratischen Matrizen, die nicht vollen Rang haben, gilt $\det(A)=0$ **Bsp** 1. Determinante für $2\times2$ Matrizen > [!warning] Ansonsten gibt es $\infty$ Lösungen > Normalengleichung hat niemals keine Lösung # Determinanten - Zahl, welche die Invertierbarkeit von quadratischen Matrizen charakterisiert: - $A \in ^{n\times n}$, $A^{-1}$ existiert genau dann wenn $\det(A)\neq0$ - Konsequenz: Für alle quadratischen Matrizen, die nicht vollen Rang haben, gilt $\det(A)=0$ **Bsp** 1. Determinante für $2\times2$ Matrizen A=\begin{bmatrix}
− > $ A − 1 $ e x i s t i e r t 2. $ 2 × 2 $ o h n e v o l l e n R a n g B=\begin{bmatrix}
You can't use 'macro parameter character #' in math mode -> $\det(B)=0$ -> $A^{-1}$ existiert nicht ## Regel von Sarrus für $3\times3$ Matrizen -> $\det(B)=0$ -> $A^{-1}$ existiert nicht ## Regel von Sarrus für $3\times3$ Matrizen C = \begin{bmatrix}
You can't use 'macro parameter character #' in math mode -> genauso aufwendig wie Regel 11 (entwicklung nach Spalte/Reihe), aber im gegensatz zu 11 nicht nützlich zur Berechnung vom charakteristischen Polynom ### Laplacescher Entwicklungssatz - Methode zur Berechnung der Determinante in beliebigen Dimensionen Für $n \times m$ Matrix, Entwicklung nach z.b. Spalte $m$: -> genauso aufwendig wie Regel 11 (entwicklung nach Spalte/Reihe), aber im gegensatz zu 11 nicht nützlich zur Berechnung vom charakteristischen Polynom ### Laplacescher Entwicklungssatz - Methode zur Berechnung der Determinante in beliebigen Dimensionen Für $n \times m$ Matrix, Entwicklung nach z.b. Spalte $m$: \det(A) = \sum_{i = 1}^n (-1)^{i+m} \cdot a_{im} \cdot \det(A_{im})
You can't use 'macro parameter character #' in math mode ## rechenregeln Determinante 1. $A \in \mathbb{R}^{n\times n}, B \in \mathbb{R}^{n\times n}: \det(AB)=\det(A)\det(B)$ 2. $\det(A^{-1})=\frac{1}{\det(A)}$ 3. $A \in \mathbb{R}^{n\times n}, \alpha \in \mathbb{R}: \det(\alpha A)=\alpha^n\det(A)$ 4. $\det(A^\top)=\det(A)$ 1 -> orthogonale Matrix $Q^{-1}=Q^\top$ $\det(I)=1$ $\det(Q^\top Q)=\det(I)=1$ 1-> $\det(Q^\top)\det(Q)=1$ 4-> $\det(Q)\det(Q)=1$ $\det(Q)^2=1$ $\det(Q)=1$ oder $\det(Q)=-1$ > #timestamp 2024-11-28 # Eigenwerte und Eigenvektoren $A \in R^{n\times n}, x \in \mathbb{R}^n$ (quadratische Matrix): x ist Eigenvektor von $A$ mit Eigenwert $\lambda \in \mathbb{R}$, wenn gilt: ## rechenregeln Determinante 1. $A \in \mathbb{R}^{n\times n}, B \in \mathbb{R}^{n\times n}: \det(AB)=\det(A)\det(B)$ 2. $\det(A^{-1})=\frac{1}{\det(A)}$ 3. $A \in \mathbb{R}^{n\times n}, \alpha \in \mathbb{R}: \det(\alpha A)=\alpha^n\det(A)$ 4. $\det(A^\top)=\det(A)$ 1 -> orthogonale Matrix $Q^{-1}=Q^\top$ $\det(I)=1$ $\det(Q^\top Q)=\det(I)=1$ 1-> $\det(Q^\top)\det(Q)=1$ 4-> $\det(Q)\det(Q)=1$ $\det(Q)^2=1$ $\det(Q)=1$ oder $\det(Q)=-1$ > #timestamp 2024-11-28 # Eigenwerte und Eigenvektoren $A \in R^{n\times n}, x \in \mathbb{R}^n$ (quadratische Matrix): x ist Eigenvektor von $A$ mit Eigenwert $\lambda \in \mathbb{R}$, wenn gilt: Ax=\lambda x
ö − $ 0 → $ i s t k e i n E i g e n v e k t o r − > t r i v i a l e L ö s u n g − e i n E i g e n v e k t o r h a t n u r e i n e n E i g e n w e r t / e i n E i g e n w e r t k a n n m e h r e r e E i g e n v e k t o r e n h a b e n B e r e c h n u n g : \begin{align}
You can't use 'macro parameter character #' in math mode - $\det(A-\lambda I)$ gibt uns ein Polynom (in $\lambda$) von Grad $n$ und wird **charakteristisches Polynom** genannt ## Eigenräume Zu jedem Eigenwert $\lambda i$ gibt es einen zugehörigen Eigenraum $E_{\lambda i}$, der durch seine Eigenvektoren aufgespannt wird. **Bsp:** eigenwert $-6$ eigenvektor $\begin{bmatrix}24\\-3\\7\end{bmatrix}$ -> $E_{-6}=span(\begin{bmatrix}24\\-3\\7\end{bmatrix})$ -> Dimensionalität 1 ### Algebreische Vielfachheit eines Eigenwertes "wie oft der Eigenwert als Nullstelle des charakteristischen Polynoms vorkommt" - bei einer $A\in \mathbb{R}^{n\times n}$ maximal $n$ EW, ein Eigenwert hat algebraische Vielfachheit max $n$ **Bsp** - $\det(A-\lambda I)$ gibt uns ein Polynom (in $\lambda$) von Grad $n$ und wird **charakteristisches Polynom** genannt ## Eigenräume Zu jedem Eigenwert $\lambda i$ gibt es einen zugehörigen Eigenraum $E_{\lambda i}$, der durch seine Eigenvektoren aufgespannt wird. **Bsp:** eigenwert $-6$ eigenvektor $\begin{bmatrix}24\\-3\\7\end{bmatrix}$ -> $E_{-6}=span(\begin{bmatrix}24\\-3\\7\end{bmatrix})$ -> Dimensionalität 1 ### Algebreische Vielfachheit eines Eigenwertes "wie oft der Eigenwert als Nullstelle des charakteristischen Polynoms vorkommt" - bei einer $A\in \mathbb{R}^{n\times n}$ maximal $n$ EW, ein Eigenwert hat algebraische Vielfachheit max $n$ **Bsp** A = \begin{bmatrix}
You can't use 'macro parameter character #' in math mode $\det(A-\lambda I) = (2-\lambda)(2-\lambda)$ -> EW 2 hat algebraische Vielfachheit $2$ ### Geometrische Vielfachheit eines Eigenwertes = dimension des zugehörigen Eigenraums $\det(A-\lambda I) = (2-\lambda)(2-\lambda)$ -> EW 2 hat algebraische Vielfachheit $2$ ### Geometrische Vielfachheit eines Eigenwertes = dimension des zugehörigen Eigenraums 1\leq \text{geometrische V.} \leq \text
You can't use 'macro parameter character #' in math mode -> zu jedem $EW$ gibt es mindestens ein Eigenvektor ## Diagonalisierbarkeit $A \in \mathbb{R}^{n\times n}$ und sei $D \in \mathbb{R}^{n\times n}$ -> zu jedem $EW$ gibt es mindestens ein Eigenvektor ## Diagonalisierbarkeit $A \in \mathbb{R}^{n\times n}$ und sei $D \in \mathbb{R}^{n\times n}$ D = \begin{bmatrix}
− M a n n e n n t A d i a g o n a l i s i e r b a r , w e n n g i l t A = SDS^
w o b e i d i e S p a l t e n v o n S d u r c h d i e ( g e o r d n e t e n ) E i g e n v e k t o r e n g e g e b e n s i n d : S = \begin{bmatrix}
ü ü − " g e o r d n e t " : R e i h e n f o l g e E i g e n w e r t e i n D $ = ^ $ R e i h e n f o l g e E V i n S − S k a n n n u r a u f g e s t e l l t w e r d e n , w e n n $ n $ E i g e n v e k t o r e n − E V m ü s s e n n i c h t n o r m a l i s i e r t s e i n − − − A i s t g e n a u d a n n d i a g o n a l i s i e r b a r , w e n n f ü r j e d e n E i g e n w e r t d i e a l g e b r a i s c h e V i e l f a c h h e i t g l e i c h d e r g e o m e t r i s c h e n V i e l f a c h h e i t A = \begin{bmatrix}
ä ä − > $ dim ( E λ 1 2 ) = 1 $ − > A V = 2 , G V = 1 − > n i c h t d i a g o n a l i s i e r b a r > [ ! n o t e ] > H ä u f i g e r F e h l s c h l u s s : I n v e r t i e r b a r k e i t u n d D i a g o n a l i s i e r b a r k e i t h ä n g e n m i t e i n a n d e r z u s a m m e n > $ $ [ 1 0 0 0 ]
-> diagonalisierbar, aber nicht invertierbar
[ 1 1 0 1 ] -> invertierbar, aber nicht diagonalisierbarA
Charakteristisches Polynom lösen
Für Polynom mit Grad ≥ 3
Bsp
det ( A − λ I ) = λ 3 + 4 λ 2 + λ − 6 -> oftmals ist eine Nullstelle gegeben durch 0,1 oder -11 + 4 + 1 − 6 = 0 ✓
λ 1 = 1
( x 3 + 4 x 2 + x − 6 ) : ( x − 1 ) = x 2 + 5 x + 6 -> det ( A − x I ) = ( x − 1 ) ( x 2 + 5 + 6 )
quadratische Funktion:− 2 , − 3
det ( A − x I ) = ( x − 1 ) ( x + 3 ) ( x + 2 ) Nützliches zu Eigenwerten
Eigenvektoren von unterschiedlichen Eigenwerte sind linear unabhängig
die Determinante ist das Produkt der Eigenwerte
det ( A ) = ∏ i = 1 n λ i => det ( A ) = 0 0
für Dreiecksmatrizen (egal ob untere oder obere) sind die Einträge auf der Hauptdiagonalen gleich den Eigenwerten
[ 1 2 3 4 0 5 6 7 0 0 8 9 0 0 0 10 ] → λ 1 = 1 , λ 2 = 5 , λ 3 = 8 , λ 4 = 10
Die Summe der Einträge auf der Hauptdiagonalen ist gleich der Summe der Eigenwerte
A = [ 1 4 2 3 ] det ( A λ I ) = ( 1 − λ ) ( 3 − λ ) − 8 = λ 2 − 4 λ − 5 = ( λ − 1 ) ( λ − 4 ) λ 1 = 5 , λ 2 = 1 λ 1 ⋅ λ 2 = − 5 det ( A ) = 3 − 8 = − 5 ✓
λ 1 + λ 2 = 4 A = [ 1 4 2 3 ] → 1 + 3 = 4
#timestamp 2024-10-05
Serie 10: Letzte Aufgabe
Normale Matrizen (A ⊤ A = A A ⊤
A v 1 = λ 1 v 1 A v 2 = λ 2 v 2 λ 1 ≠ λ 2 ⟹ v 1 ⊤ v 2 = 0 Beweisidee: Zeigen, das A A ⊤ E W E V
( A v 1 ) ⊤ v 2 = λ 1 v 1 ⊤ v 2 ( A v 1 ) ⊤ v 2 = v 1 ⊤ A ⊤ v 2 = v 1 λ 2 v 2 λ 1 v 1 ⊤ v 2 = λ 2 v 1 ⊤ v 2 ⟹ v 1 ⊤ v 2 = 0 ◻ Wie zeigen, dass A A ⊤
det ( A − λ I ) = det ( ( A − λ I ) ⊤ ) = det ( A ⊤ − λ I ) -> Für gleiche EV:
( A − λ I ) ⏟ B v = 0 → und ( A ⊤ − λ I ) ⏟ B ⊤ v = 0 → Beide LGS müssen gleiche Lösung haben!
ü ü B B ⊤ = B ⊤ B selbst überprüfen -> Hinweis: für normale Matrizen haben B B ⊤
also haben B v = 0 → B ⊤ v = 0 → A A ⊤
Spektralsatz
Symmetrische Matrizen (können immer diag.) haben orthogonale Eigenvektoren und lassen sich durch orthogonale Matrizen diagonalisieren:
A = U D U ⊤
Die Spalten von U normierte Eigenvektoren, D ist eine Diagonalmatrix mit Eigenvektoren
U = [ u 1 , u 2 , … , u n ] , D = [ λ 1 0 ⋱ 0 λ n ]
Wenn A
A = ∑ i = 1 n λ i u i u i ⊤ Bsp
A = [ 1 4 4 1 ] → relativ einfach: v 1 = [ 1 1 ] EV mit EW λ 1 = 5 v 2 = [ 1 − 1 ] A v 1 ⊥ v 2
A v 2 = [ − 3 3 ] λ 2 = − 3
Für Diagonalisieren: E V
A = 1 2 [ 1 1 1 − 1 ] [ 5 0 0 − 3 ] 1 2 [ 1 1 1 − 1 ] = 5 u 1 u 1 ⊤ − 3 u 2 u 2 ⊤ = 5 2 [ 1 1 ] [ 1 1 ] − 3 2 [ 1 − 1 ] [ 1 − 1 ] = [ 1 4 4 1 ] ✓ Definitheit
Eine symmetrische Matrix A ∈ R n × n positiv definit , wenn gilt:
x ⊤ A x ≥ 0 ∀ x ∈ R n x ⊤ A x = 0 ⟹ x = 0 →
Falls nur 1 A positiv semi-definit
Positiv definit: E W > 0
Positive-semi-definit: E W ≥ 0
nützlicher Trick -> gilt nicht nur für symm. M.
ö x ⊤ A x = ∑ i = 1 n ∑ j = 1 n x i A i j x j auch möglich: y ⊤ A x = ∑ i = 1 n ∑ j = 1 n y i A i j x j Proof
A = ∑ k = 1 n λ k v k v k ⊤ -> jede x ∈ R n v 1 , … , v n
x = ∑ i = 1 n a i v i A x = ∑ i = 1 n a i A v i → = ∑ i = 1 n a i λ i v i → x ⊤ A x = ( ∑ j = 1 n a i v i → ) ⊤ ( ∑ i = 1 n a i λ i v i → ) = ∑ j = 1 n ∑ i = 1 n a j a i λ i v j → ⊤ v i → → EV sind orthogonal = ∑ i = 1 n a i 2 λ i -> ∀ x : x ⊤ A x ≥ 0 ⟺ λ i ≤ 0 ∀ i
Bsp
[ 3 3 3 3 ] positiv definit?
nicht invertierbar -> mind. 1x eigenwert u1 det ( A ) = 1 λ 1 = 0
v 1 = [ 1 − 1 ] → v 2 ⊥ v 1 → v 2 = [ 1 1 ] A v 2 = [ 6 6 ] → λ 2 = 6
Prüfungsaufgabe HS 18
[ 2 1 1 1 1 2 1 2 1 ] -> symmetrisch -> EW orthogonal
Zeilensumme 4 → λ 1 = 4
Musterlösung:
det ( A − λ I ) = det [ 2 − λ 1 1 1 1 − λ 2 1 2 1 − λ ] = ( 2 − λ ) ( 1 − λ ) 2 + 2 + 2 − ( 1 − λ ) − 4 ( 2 − λ ) − ( 1 − λ ) = ( 2 − λ ) ( 1 − λ ) 2 + 6 λ − 6 = ( 2 − λ ) ( 1 − Λ ) 2 − 6 ( 1 − λ ) = ( 1 − λ ) ( ( 2 − λ ) ( 1 − λ ) − 6 ) → λ 1 = 1 = ( 1 − λ ) ( λ 2 − 3 λ + 2 − 6 ) = ( 1 − λ ) ( λ 2 − 3 λ − 4 ) → Trick: λ 2 + λ 3 = − ( − 3 ) λ 2 λ 3 = − 4 -> λ 2 = − 1 λ 3 = 4
EV berechnen:
[ 2 − 1 1 1 1 1 − 1 2 1 2 1 − 1 ] - Matrix muss Rang 2 x 3
II x 1 = − 2 x 3 x 2 = x 3 v 1 = [ − 2 1 1 ]
λ 2 = − 1 v 2 = [ 0 1 − 1 ] λ 3 = 4 v 3 = [ 1 1 1 ] v 1 , v 2 → v 3
b) Bestimme eine orthonormale Basis aus den EVb 1 = 1 6 [ − 2 1 1 ] , b 2 = 1 2 [ 0 1 − 1 ] , b 3 = 1 3 [ 1 1 1 ]
c) berechne
e A = lim n → ∞ ∑ n = 0 N 1 n ! A n -> A symm., daher:
A = U D U ⊤ A 2 = U D U ⊤ U D U ⊤ = U D 2 U ⊤ A n = U D n U ⊤ ⟹ D = [ 1 0 0 0 − 1 0 0 0 4 ] , D n = [ 1 n 0 0 0 ( − 1 ) n 0 0 0 4 n ] e A = lim N → ∞ ∑ n = 0 N 1 n ! A n = lim N → ∞ ∑ n = 1 N 1 n ! U D n U ⊤ = U ( lim N → ∞ ∑ n = 0 N D n n ! ) U ⊤ = U ( lim N → ∞ [ ∑ n = 0 N 1 n n ! 0 0 0 ∑ n = 0 N ( − 1 ) n n ! 0 0 0 ∑ n = 0 N 4 n n ! ] ) U ⊤ da: e x = lim N → ∞ ∑ n = 0 N x n n !
= U ( [ e 1 0 0 0 e − 1 0 0 0 e 4 ] ) U ⊤
#timestamp 2024-12-12
Singulärwertszerlegung (SVD)
A ∈ R m × n U ∈ R m × m , V ∈ R m × m
A = U Σ V ⊤ wobei Σ = d i a g ( σ 1 , σ 2 , … , σ p ) ∈ R m × n
σ 1 , … , σ p SIngulärwerte von Aσ 1 ≥ ⋯ ≥ σ p ≥ 0
Bsp
[ 1 1 1 1 1 1 ] = 1 6 [ 2 − 3 0 2 3 1 2 0 − 2 ] [ 6 0 0 0 0 0 ] 1 2 [ 1 1 1 − 1 ] wobei σ 1 = 6 , σ 2 = 0
U,V haben normierte, orthogonale Spalten
Berechnung SVD
Singulärwerte sind Wurzeln der EW von A ⊤ A A A ⊤
immer Matrix auswählen, die kleiner ist
Bsp
[ 1 1 1 1 1 1 ] -> A ⊤ A ∈ R 2 × 2 A A ⊤ ∈ R 3 × 3 A ⊤ A
A ⊤ A = [ 3 3 3 3 ] -> da symmetrisch, sind eingenvektoren orthogonal (?)
det ( A ⊤ A − λ I ) = ( 3 − λ ) 2 − 9 = λ ( λ − 6 ) λ 1 = 0 , λ 2 = 6 σ 1 = 6 , σ 2 = 0
Σ = [ 6 . . 0 . . ] -> hat immer gleiche Dimensionen wie A
Spalten von U A A ⊤ V E V A ⊤ A
u i ⊤ A v i = σ i u i = A v i σ i v i = A ⊤ u i σ i
Strategie:
EV von kleineren Matrix (U oder V) berechnen
Über obrige Formel Spalten der anderen matri berechnen
A ⊤ A = [ 3 3 3 3 ] -> Spalten von V A ⊤ A V ∈ R 2 × 2 U ∈ R 3 × 3
Berechnung V
( A ⊤ A − λ 1 I ) x = 0 → x 1 = x 2 v 1 = 1 2 [ 1 1 ]
-> da A ⊤ A v 2 ⊥ v 1
v 2 = 1 2 [ 1 − 1 ]
V = 1 2 [ 1 1 1 − 1 ] -> muss noch transponiert werden, in unserem Beispiel schon symmetrisch
Berechnung U
Singulärwert is 0 u 1
Aber brauchen u 2 ⊥ u 1 u 3 ⊥ u 1 , u 2
für u 3
u 1 = A v 1 σ 1 = 1 6 [ 1 1 1 1 1 1 ] 1 2 [ 1 1 ] = ⋯ = 1 6 [ 2 2 2 ] u 2 = 1 2 [ 1 − 1 0 ] = 1 6 [ 3 − 3 0 ] u 3 = 1 6 [ 1 1 − 2 ] -> v 3 #todo : üben, orthogonale Vektoren von Hand erkennen
U = 1 6 [ 2 3 1 2 − 3 1 2 0 − 2 ] Ergebnis:
[ 1 1 1 1 1 1 ] = 1 6 [ 2 − 3 0 2 3 1 2 0 − 2 ] [ 6 0 0 0 0 0 ] 1 2 [ 1 1 1 − 1 ]
wir können A
A = ∑ i = 1 n σ i u i v i ⊤
"Anzahl SIngulärwerte > 0" = Rang r
A = 6 v 1 v 1 ⊤ = 6 1 6 [ 2 2 2 ] 1 2 [ 1 1 ] = [ 1 1 1 1 1 1 ] Bsp 2 : SVD von A = [ 1 2 3 ] ∈ R 1 × 3
U ∈ R 1 × 1 V ∈ R 3 × 3
Singulärwerte berechnen von A A ⊤ ∈ R 1 × 1 A ⊤ A ∈ R 3 × 3
det ( A A ⊤ − λ I ) = 14 − λ → σ 1 = 14
Σ = [ 14 0 0 ] U U = 1 − 1
Berechnung V
wir müssen wieder v 2 ⊥ v 1
v 3 v 3 ⊥ v 2 , v 1
ü v 1 = A ⊤ u 1 σ 1 = 1 14 [ 1 2 3 ] v 2 = 1 5 [ − 2 1 0 ] v 3 = [ 1 2 − 5 3 ] = 1 70 [ 3 6 − 5 ] 1 , 2 um orthogonal zu v 2 , − 5 3 für v 1 ( v 3 ′ = 1 3 ⋅ normiert [ 3 6 − 5 ] ) für v 3 v 2 1 ∗ 1 + 2 ∗ 2 + z ∗ 3 = 0 z = − 5 3
V = [ 1 14 − 2 5 3 70 2 14 1 5 6 70 3 14 0 − 5 70 ] nicht vergessen,
V zu transponieren
A = U Σ V ⊤ Wenn
A eine quadratische Matrix ist, dann sind die Singulärwerte von
A gleich den Beträgen der Eigenwerten von
A .
Ausgleichsrechnung mit SVD
Erinnerung: suchen x ∈ R n
| | A x − b | | 2
Lösung über Normalengleichung
A ⊤ A x = A ⊤ b ü | | A x − b | | 2 2 = | | U Σ V ⊤ x − U U ⊤ b | | 2 2 | | U x | | 2 2 = | | x | | 2 2 für U orthogonal = | | Σ V ⊤ x − U ⊤ b | | 2 2 Zerlegung in Untermatrizen!
= | | [ Σ r 0 0 0 ] [ v 1 ⊤ v 2 ⊤ ] x − [ U 1 ⊤ U 2 ⊤ ] b | | 2 2 = | | Σ r v 1 ⊤ x − U 1 ⊤ b | | 2 2 + | | U 2 ⊤ b | | 2 2 -> minimal für Σ r V 1 ⊤ x = U 1 ⊤ b
x = V 1 Σ r − 1 U 1 ⊤ b Bsp :
[ 1 1 1 1 1 1 ] = 1 6 [ 2 − 3 0 2 3 1 2 0 − 2 ] [ 6 0 0 0 0 0 ] 1 2 [ 1 1 1 − 1 ] b = [ 1 2 1 ] Finde x | | A x − b | | 2
Σ r = 6 , v 1 = 1 2 [ 1 1 ] , u 1 ⊤ = 1 6 [ 2 2 2 ] , Σ r − 1 = 1 6 x = v 1 Σ r − 1 U 1 ⊤ b = ⋯ = 2 3 [ 1 1 ]
Lösung x = V 1 Σ r − 1 U 1 ⊤ b | | x | | 2
Vergleich mit Normalengleichung:
A ⊤ A = [ 3 3 3 3 ] , A ⊤ b = [ 4 4 ] Normalengleichung: A ⊤ A x = A ⊤ b
[ 3 3 3 3 ] [ x 1 x 2 ] = [ 4 4 ] 3 x 1 3 x 2 = 4 → x 1 = 4 3 − x 2
x = [ 4 3 − t t ] = [ 4 3 0 ] + t [ − 1 1 ] | | x | | 2 = ( 4 3 − t ) 2 + t 2 = 2 t 2 + 8 3 t + 16 9
δ δ t | | x | | 2 = 4 t − 8 4 = ! 0 für minimale Formt = 2 3
x = 2 3 [ 1 1 ]
Moore-Penrose Pseudoinverse
Pseudoinverse A † S V D
A = U Σ V ⊤ → A † = V Σ † U ⊤ wobei
Σ † = [ 1 σ 1 0 0 0 1 σ 2 0 0 0 ⋱ ] -> wenn σ i = 0 1 σ 1 = 0 0
Eigenschaften: A ∈ R m × n ⟹ A ⊤ ∈ R n × n
A A † A = A A † A A † = A †
Falls A − 1 A † = A − 1
Bsp
[ 1 1 1 1 1 1 ] = 1 6 [ 2 − 3 0 2 3 1 2 0 − 2 ] [ 6 0 0 0 0 0 ] 1 2 [ 1 1 1 − 1 ] A + = V Σ + U ⊤ = 1 2 [ 1 1 1 − 1 ] [ 1 6 0 0 0 0 0 ] 1 6 [ 2 2 2 3 − 3 0 1 1 − 2 ] = ⋯ = 1 6 [ 1 1 1 1 1 1 ]
Lösung der Ausgleichsrechnung ist gegeben durch:
x = A † b -> Lösung hat minimale (euklidische) Norm unter allen Lösungen
Bsp (vorheriges:)
A † = 1 6 [ 1 1 1 1 1 1 ] , b = [ 1 2 1 ] x = A † b = 2 3 [ 1 1 ] ✓ Matrixnormen mit SVD:
| | A | | 2 = max x ≠ 0 | | A x | | | | x | | = σ 1 -> grösster Singulärwert